Rate limit: o que fazer quando a API responde 429
A API respondeu 429 e a automação parou. Entenda o que é rate limit, como ler o Retry-After e como repetir chamadas com recuo exponencial sem piorar a situação.
Sua automação estava rodando bem até que, num dia de volume alto, começou a receber uma resposta estranha: 429 Too Many Requests. Na verdade, nada quebrou do lado da API. Ela só está pedindo calma. Esse limite de chamadas tem nome, rate limit, e lidar bem com ele é a diferença entre uma integração que se recupera sozinha e uma que piora o problema a cada tentativa.
Neste guia, você vai entender por que APIs limitam chamadas, o que o código 429 informa e como repetir requisições de um jeito que ajuda em vez de atrapalhar.
O que é rate limit
Rate limit é o limite de requisições que um serviço aceita num intervalo de tempo. Em geral, ele protege o servidor de sobrecarga, distribui a capacidade de forma justa entre os clientes e dificulta abusos.
Quando você passa do limite, a resposta mais comum é o código HTTP 429. Segundo a MDN, ele indica que o cliente enviou requisições demais num certo tempo, e o mecanismo de pedir ao cliente que diminua o ritmo é chamado justamente de rate limiting. O código foi definido na RFC 6585, de 2012.
Rate limit: leia o Retry-After antes de qualquer coisa
A resposta 429 pode trazer um cabeçalho chamado Retry-After, que diz quanto tempo esperar antes de tentar de novo. No exemplo da MDN, o servidor responde Retry-After: 3600, ou seja, novas requisições só serão aceitas depois de 3.600 segundos, uma hora.
Por isso, a primeira regra é simples: se o servidor disse quanto esperar, espere esse tempo. Afinal, tentar antes só gera mais respostas 429.
Muitas APIs também informam, em respostas normais, quantas chamadas restam na janela atual. Vale ler a documentação do serviço para saber quais cabeçalhos ele usa.
Por que repetir de qualquer jeito piora
Quando não há Retry-After, a tentação é repetir imediatamente. Porém, esse é o pior caminho. Um texto da AWS Builders’ Library explica o motivo: quando a falha vem de sobrecarga, novas tentativas que aumentam a carga podem piorar muito a situação, e ainda manter a carga alta depois que o problema original foi resolvido.
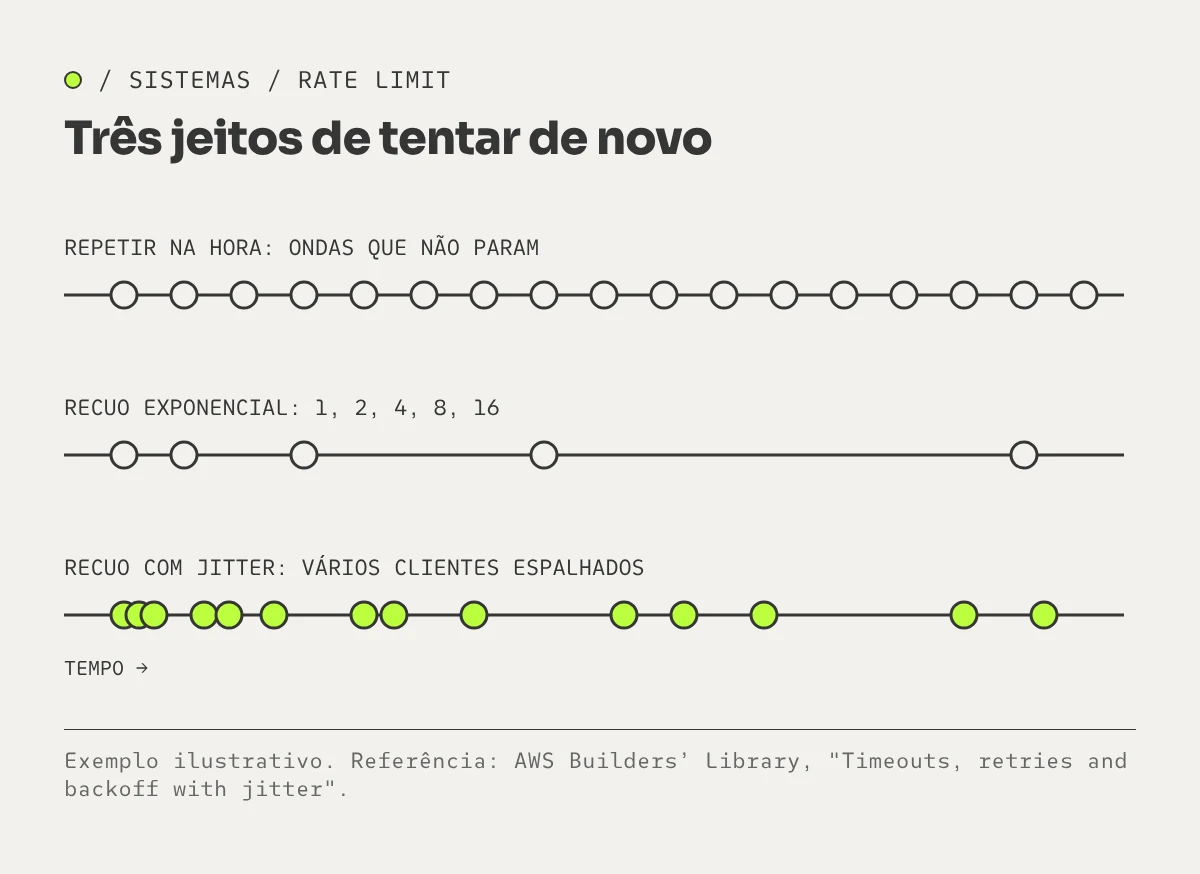
Imagine cem automações recebendo erro ao mesmo tempo e tentando de novo um segundo depois. Então, o servidor recebe outra onda igual, falha de novo, e o ciclo se repete.
Recuo exponencial com jitter
A técnica recomendada tem duas partes. A primeira é o recuo exponencial (exponential backoff): o tempo de espera aumenta a cada tentativa, por exemplo 1, 2, 4 e 8 segundos. Assim, quem está com problema para de insistir no mesmo ritmo.
A segunda é o jitter, uma dose de aleatoriedade no tempo de espera. Segundo o mesmo texto da AWS, ele espalha as novas tentativas no tempo, evitando que clientes que falharam juntos voltem todos no mesmo instante.
Um roteiro para a sua automação
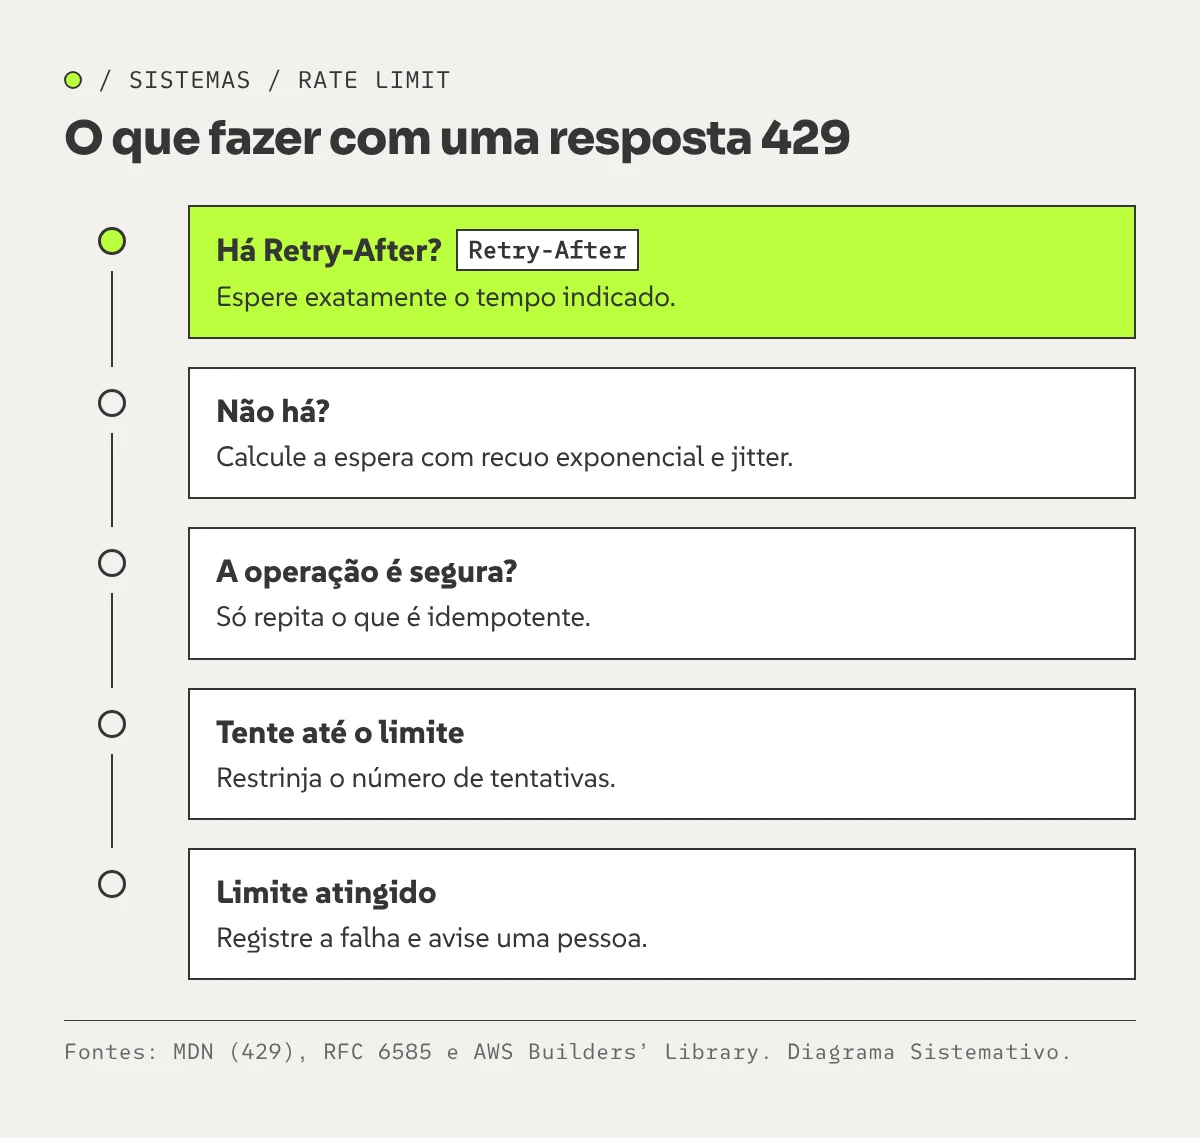
- Respeite o Retry-After quando ele existir.
- Use recuo exponencial com jitter quando não houver indicação do servidor.
- Limite o número de tentativas. A AWS recomenda restringir quantas vezes o cliente repete. Depois disso, registre a falha e avise alguém.
- Só repita operações seguras. Chamadas que criam ou cobram algo precisam ser idempotentes antes de serem repetidas.
- Reduza a necessidade de chamadas. Agrupe requisições, guarde respostas que não mudam e prefira webhooks a consultas repetidas quando o serviço oferecer.
Em ferramentas como o n8n, muitos nós oferecem opções de nova tentativa e espera entre execuções. Se você está montando uma integração do zero, vale revisitar como integrar uma API no n8n já pensando nesse comportamento.
Limite não é defeito
É fácil ver o 429 como um obstáculo. Na prática, ele é uma conversa: o servidor está dizendo quanto consegue atender. Então, integrações bem feitas escutam essa resposta e ajustam o ritmo. Afinal, uma automação que sabe esperar é uma automação que termina o trabalho, mesmo nos dias de pico.
/ Conexões
Próximas conexões
Autor
Gledson Dias